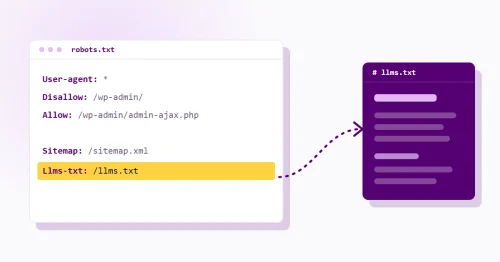

Faut-il ajouter le lien du llms.txt dans le robots.txt, comme on le fait déjà pour le sitemap ? L’idée paraît logique. Mais rien ne montre que ça serve à quelque chose.
Points clés
- La norme du robots.txt autorise d’autres lignes que les règles, mais elles n’ont d’effet que si un robot décide de les lire.
- Google ne prend en charge que quatre champs (user-agent, allow, disallow et sitemap). OpenAI, Anthropic, Perplexity et Mistral ne mentionnent aucune ligne llms.txt.
- La proposition llms.txt elle-même recommande un lien dans le HTML ou dans l’en-tête HTTP, pas le robots.txt.
Ce que dit la norme du robots.txt
Le robots.txt est normalisé depuis septembre 2022 par la RFC 9309 de l’IETF. Elle définit des groupes de règles : une ou plusieurs lignes User-agent, suivies de règles Allow et Disallow.
Pour tout le reste, sa section « Other Records » laisse chaque robot libre d’interpréter d’autres lignes, comme Sitemap. Une seule condition : ces lignes ne doivent pas perturber la lecture des règles standard.
Une ligne vers le llms.txt est donc permise par la norme. Mais elle n’a d’effet que si un robot a décidé de la lire. La ligne Sitemap fonctionne parce que les moteurs l’ont adoptée et documentée. Personne ne l’a fait pour le llms.txt.
Google ne lit que quatre champs
Dans sa documentation sur l’interprétation du robots.txt, Google liste les quatre champs qu’il prend en charge : user-agent, allow, disallow et sitemap. Les autres, comme crawl-delay, ne sont pas pris en charge. Une ligne vers le llms.txt ne l’est donc pas non plus.
Aucun éditeur d’IA ne documente cette ligne
Les pages pour les propriétaires de sites d’OpenAI, d’Anthropic, de Perplexity et de Mistral expliquent comment autoriser ou bloquer leurs robots dans le robots.txt. Aucune ne mentionne de ligne llms.txt dans ce fichier.
Le cas d’Anthropic est parlant. Elle précise prendre en charge Crawl-delay, une extension du robots.txt qui ne fait pas partie de la norme. Un éditeur sait donc signaler une ligne hors norme quand il la lit. Aucun ne le fait pour le llms.txt.
Côté Microsoft, aucune documentation officielle sur le sujet n’a été trouvée.
La proposition llms.txt elle-même ne le demande pas
La version 2 de la proposition, mise à jour le 10 août 2026, ne passe pas par le robots.txt pour aider les agents à trouver le fichier. Elle recommande un lien rel="describedby" qui pointe vers le llms.txt, à ajouter en balise <link> dans le HTML ou en en-tête HTTP Link:. Le robots.txt n’y sert que de point de comparaison, pour rappeler que les deux fichiers n’ont pas le même rôle.
Précision : aucune donnée trouvée ne montre que les agents d’IA utilisent réellement ce mécanisme.
En pratique
Chez un robot qui respecte la norme, une ligne llms.txt dans le robots.txt ne casse rien. Mais elle n’a aucun effet documenté. Si on vous la présente comme un levier de visibilité dans les IA, la réponse est la même que pour le fichier llms.txt lui-même : rien ne le démontre.
Sources
- IETF, RFC 9309, Robots Exclusion Protocol (septembre 2022)
- Google Search Central, interprétation de la spécification robots.txt (mise à jour le 31 août 2026)
- llmstxt.org, The /llms.txt file, v2 (mise à jour le 10 août 2026)
- OpenAI, documentation de ses robots
- Anthropic, robots de Claude (mise à jour le 7 avril 2026)
- Perplexity, documentation de ses robots
- Mistral AI, documentation de ses robots

