Schema Praetor, l'outil gratuit de TL;DR SEO pour les données structurées
Les données structurées de tout votre site, en un crawl.
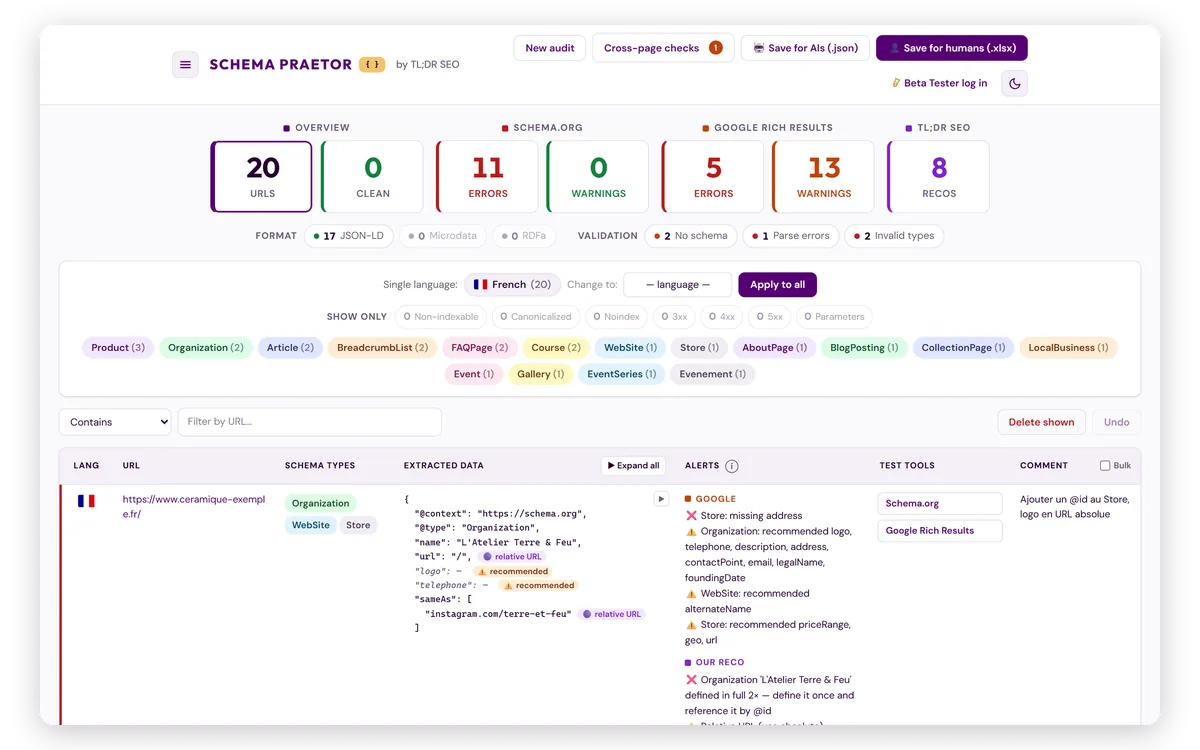
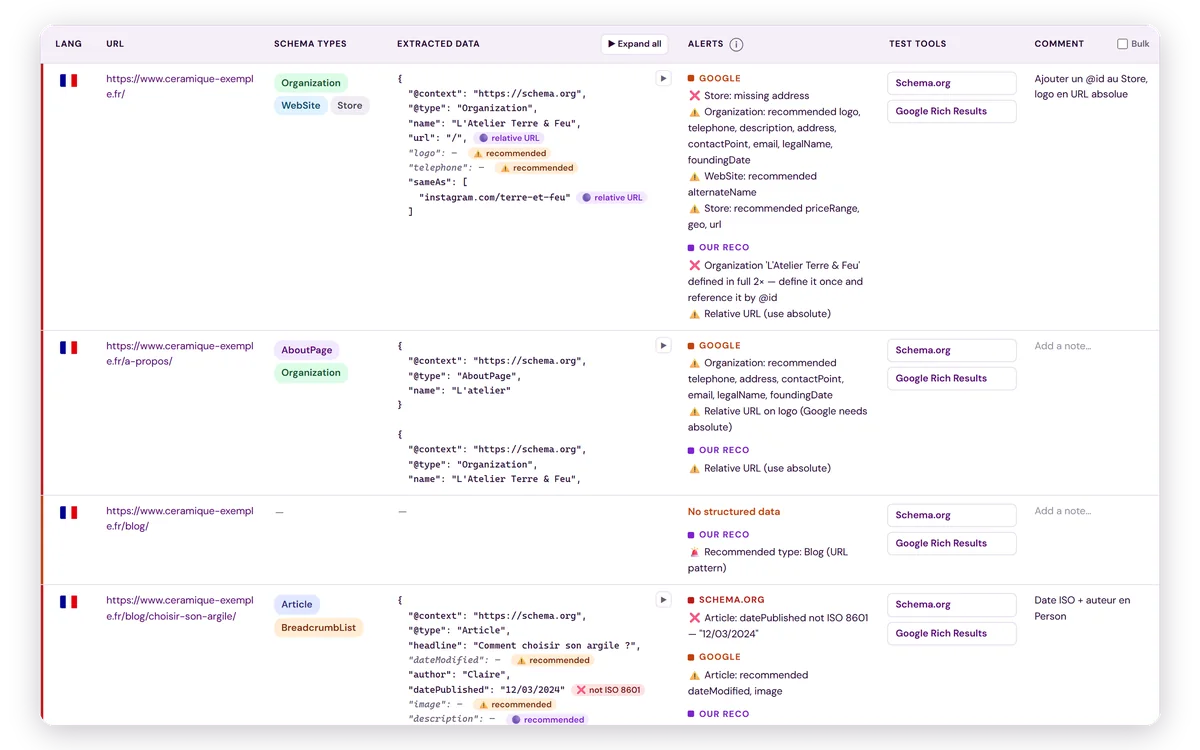
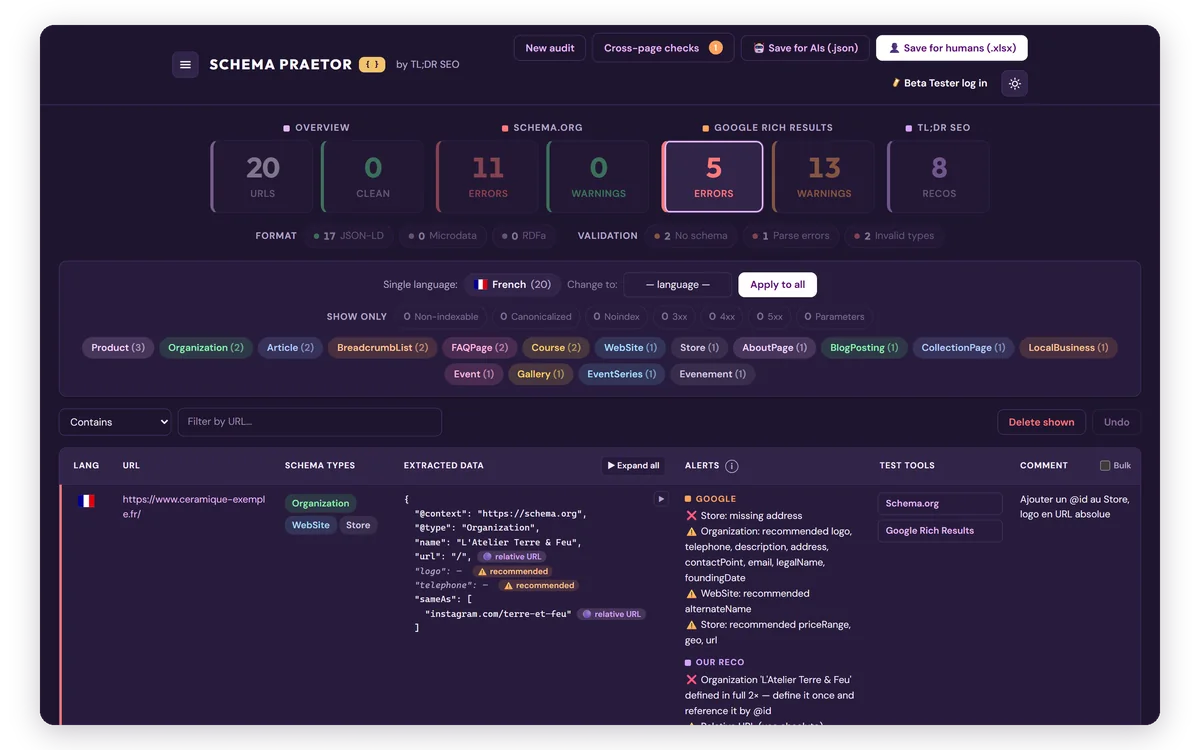
Schema Praetor explore votre site et extrait les données structurées de chaque page : JSON-LD, Microdata et RDFa. Chaque bloc est vérifié selon schema.org et les résultats enrichis de Google, avec en plus les recommandations TL;DR SEO. Chaque alerte indique qui la signale.
Gratuit, sans inscription, jusqu'à 100 pages par crawl. Un site plus grand ? L'accès Beta Tester monte à 2 000 pages par crawl.
TL;DR
Schema Praetor est un outil gratuit qui crawle un site et vérifie les données structurées de chaque page. Pour chaque URL, vous voyez les types schema.org trouvés, les données extraites et une alerte par problème, avec sa source : schema.org, Google ou une recommandation TL;DR SEO. Des contrôles sur tout le site repèrent les entités de l'entreprise et les problèmes qui touchent plusieurs pages. Vous exportez le tout en Excel, ou en JSON pour faire réécrire vos données structurées par une IA.
Qu'est-ce que Schema Praetor vérifie ?
Chaque alerte indique qui la signale, pour distinguer une vraie erreur d'une simple amélioration.
Erreurs schema.org
Types inconnus, mauvais types de données, structure cassée. Tout ce que le vocabulaire schema.org n'autorise pas.
Résultats enrichis Google
Propriétés obligatoires ou recommandées pour les résultats enrichis, seulement pour les types que Google prend encore en charge.
Recommandations TL;DR SEO
Bonnes pratiques au-delà de Google et de schema.org, tirées de mes audits.
Trois formats
JSON-LD, Microdata et RDFa.
Pages sans balisage et erreurs de lecture
Les pages sans aucune donnée structurée, et les blocs que l'outil n'arrive pas à lire.
Contrôles sur tout le site
Les entités de l'entreprise trouvées sur le site, et les problèmes qui touchent plusieurs pages.
Des résultats faciles à trier
Des cartes qui filtrent
Un clic sur « Erreurs » de Google n'affiche que les pages concernées.
Filtrer les URL
Par texte (contient, ne contient pas, commence par…), par langue, ou en masquant les pages non indexables, canonicalisées, en noindex, en 3xx, 4xx, 5xx ou avec paramètres.
Données extraites et outils de test
Les données de chaque page, dépliables, et un lien direct vers le test des résultats enrichis de Google et le validateur de schema.org.
Commentaires et exports
Une colonne pour noter les corrections, ligne par ligne ou en masse. Export Excel, et projet JSON à reprendre plus tard ou à confier à une IA.
Version gratuite et accès Beta Tester
Gratuit, sans inscription : jusqu'à 100 pages par crawl, un site par jour (3 crawls). Le robots.txt est toujours respecté.
Accès Beta Tester : jusqu'à 2 000 pages par crawl, 5 crawls par jour, import d'un crawl en CSV (avec le code des données structurées extrait par votre crawler), option « site de préproduction » qui ignore le robots.txt, et pas de file d'attente.
Demander l'accès Beta TesterFAQ
Schema Praetor est-il gratuit ?
Oui. La version gratuite ne demande aucun compte : 100 pages par crawl, un site par jour.
Mon site a plus de 100 pages, comment faire ?
L'accès Beta Tester monte à 2 000 pages par crawl. Pour un audit complet de votre site, vous pouvez aussi me le demander.
Quelle différence entre une erreur schema.org et une erreur Google ?
Une erreur schema.org rend le balisage invalide. Une erreur Google rend la page inéligible au résultat enrichi, même si le balisage reste valide. Les recommandations TL;DR SEO sont des améliorations, pas des erreurs.
Schema Praetor respecte-t-il le robots.txt ?
Oui. Si votre site bloque les robots, l'outil vous prévient avant de lancer le crawl.
À quoi sert l'export JSON ?
Il contient les données et les alertes de chaque page, ainsi que les contrôles sur tout le site. Donnez-le à une IA pour qu'elle réécrive vos données structurées, ou rechargez-le plus tard pour reprendre l'audit.
Mes commentaires sont-ils enregistrés ?
Ils restent dans votre navigateur. Sauvegardez le projet (.json) pour les retrouver.
L'interface est-elle en français ?
Non, l'outil est en anglais.
Je veux vérifier une seule page.
Heimdall SEO, l'extension Chrome, vérifie les données structurées de la page ouverte, en un clic.
Une question, un bug, une idée ?
Un type mal détecté, une alerte qui vous semble fausse, un site que l'outil n'arrive pas à crawler : écrivez-moi. Précisez l'adresse de la page, ça m'aide à reproduire le problème.